
Ouvrez le sélecteur de modèle de Claude et vous tombez sur quatre noms : Haiku, Sonnet, Opus et Fable. Anthropic les classe du plus léger au plus puissant, ce qui pousse à une conclusion logique : prendre le plus gros, puisqu'il est là. C'est rarement le bon choix, et c'est même souvent un mauvais calcul.
Pour le vérifier, j'ai donné exactement les mêmes consignes aux quatre modèles, dans la même interface, et j'ai comparé ce qui en sortait. Tout est dans la vidéo, en six minutes. Cet article reprend les résultats, ajoute ce que je n'avais pas le temps de détailler à l'écran (les formules, les prix, le réglage d'effort) et se termine par un outil qui vous dit quel modèle et quel effort régler pour votre tâche.
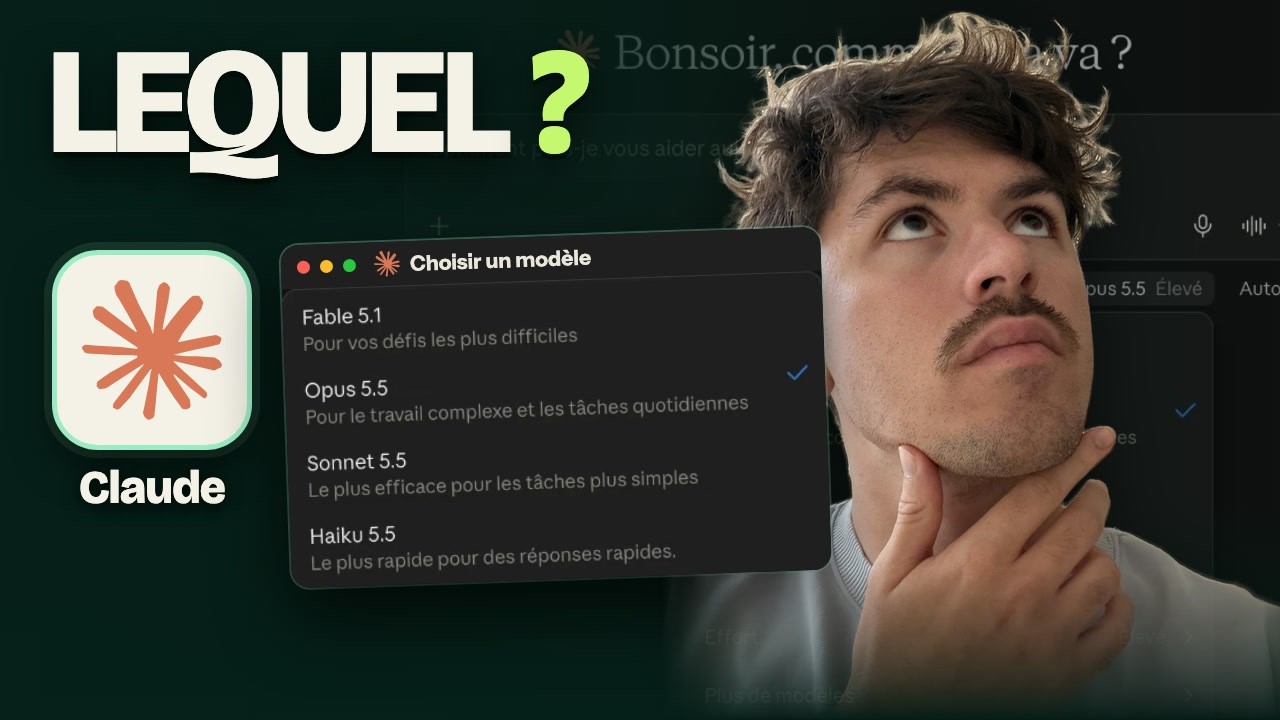 Haiku, Sonnet, Opus ou Fable : le comparatif en 5 min 57
Les chapitres de la vidéo : 0:00 la réponse courte · 0:41 test 1, un planning impossible · 1:23 test 2, construire un vrai outil · 2:56 à quoi servent les gros modèles · 4:16 et Mythos ? · 4:45 l'effort, le réglage caché · 5:49 en résumé.
À retenir
- Claude propose quatre modèles en octobre 2026 : Haiku 4.5, Sonnet 5.5, Opus 5.5 et Fable 5.1, du plus rapide au plus capable.
- En version gratuite, je reste sur Sonnet. En version payante, je règle Opus par défaut : il fait presque tout ce que fait Fable, pour une fraction du coût.
- Sur une question piège (un planning impossible), les quatre modèles ont trouvé qu'aucune solution n'existait, Haiku compris.
- Sur un simulateur de TJM freelance, c'est Opus qui a eu la meilleure idée métier. Fable a livré le tableau de bord le plus technique, sans cette idée.
- Les gros modèles font la différence sur les tâches en plusieurs étapes (connecteurs, skills, fichiers) et sur le code long, pas sur une question isolée.
- Le niveau d'effort ne rend pas le modèle plus intelligent : il lui donne plus de temps de réflexion, et il consomme votre quota d'autant.
Quel modèle Claude choisir : la réponse courte
Si vous ne deviez lire qu'un paragraphe : en gratuit, Sonnet ; en payant, Opus. Haiku pour les petites tâches à la chaîne, Fable pour les gros chantiers de code ou les tâches longues qu'Opus ne termine pas.
| Modèle | Pour quoi | Formule | Mon usage |
|---|---|---|---|
| Haiku 4.5 | Le plus rapide : questions courtes, reformulations, tri, tâches répétitives | Toutes, gratuite comprise | Les questions simples, quand la vitesse compte |
| Sonnet 5.5 | L'usage courant : rédaction, synthèse, documents, tableurs, code simple | Toutes, gratuite comprise | Mon choix par défaut en version gratuite |
| Opus 5.5 | Le travail complexe : raisonnement long, analyse, tâches en plusieurs étapes | Pro et au-dessus | Mon choix par défaut en version payante |
| Fable 5.1 | Le plus capable : code ambitieux, tâches très longues et exigeantes | Max et sièges Premium ; Pro avec crédits d'usage | Seulement quand Opus plafonne |
Pourquoi pas Fable tout le temps, puisqu'il est le plus puissant ? Parce qu'il est souvent trop lourd pour la tâche demandée. Il réfléchit plus longtemps, coûte nettement plus cher et, sur une demande ordinaire, ne rend pas un meilleur résultat qu'Opus. Anthropic l'écrit d'ailleurs à sa façon : Opus 5.5 atteint, selon ses propres mesures, le niveau de Fable 5.1 sur la plupart des tâches. Les deux tests qui suivent le montrent concrètement.
Gamme et prix relevés le 14 octobre 2026
Dans l'application Claude et sur la page tarifs d'Anthropic. Les noms de version changent plusieurs fois par an, la logique du choix beaucoup moins. Pour le détail des formules, voyez l'abonnement Claude, prix et formules.
Les quatre modèles Claude en un coup d'œil
Les quatre modèles partagent la même interface, les mêmes outils et les mêmes connecteurs. Ce qui change : la vitesse, la profondeur de raisonnement, et le prix de chaque mot produit. À l'API, l'écart se lit directement :
| Modèle | Entrée, par million de tokens | Sortie, par million de tokens | Écart avec Haiku |
|---|---|---|---|
| Haiku 4.5 | 1 $ | 5 $ | Référence |
| Sonnet 5.5 | 2 $ | 10 $ | × 2 |
| Opus 5.5 | 4 $ | 20 $ | × 4 |
| Fable 5.1 | 10 $ | 50 $ | × 10 |
Dans l'abonnement, vous ne voyez pas ces prix, mais vous les payez quand même : chaque message consomme votre limite de session en proportion du modèle et de l'effort choisis. Un échange avec Fable en effort maximal pèse beaucoup plus lourd qu'un échange avec Sonnet en effort moyen. C'est pour ça que le choix du modèle n'est pas qu'une question de qualité : c'est aussi une question d'autonomie sur la journée.
Le plan gratuit donne accès à Sonnet et Haiku. Opus arrive avec Pro, à 20 $ par mois (17 $ en annuel). Fable est inclus dans Max (100 $ ou 200 $ par mois), jusqu'à la moitié de la limite hebdomadaire, et s'utilise sur Pro avec des crédits d'usage facturés en plus. Je détaille ce que permet le gratuit dans Claude AI gratuit.
Test 1 : un planning impossible
Premier test, volontairement piégé. J'ai demandé à chaque modèle de caser une série de rendez-vous dans une semaine, avec des contraintes de disponibilité et d'enchaînement qui, mises bout à bout, s'excluent. Il n'existe aucun planning valable. La bonne réponse n'est donc pas un planning : c'est « ce n'est pas possible, voici pourquoi ».
C'est le genre de question où un modèle faible a tendance à inventer : il veut rendre service, alors il produit un planning qui a l'air propre et qui viole discrètement une contrainte. Le meilleur rempart reste de donner au modèle toutes les données dans le message : sur ce point, le contexte compte plus que la formulation du prompt.
Résultat : les quatre ont trouvé. Haiku, le plus petit, a identifié le conflit, expliqué qu'aucune solution ne respectait toutes les contraintes, puis m'a posé des questions pour savoir laquelle assouplir. Sonnet, Opus et Fable ont abouti à la même conclusion, avec des explications plus ou moins détaillées.
Ce que ce test dit vraiment
Sur une question bien posée, avec toutes les données dans le message, même le plus petit modèle de Claude raisonne juste. L'écart entre les modèles ne se joue pas sur la logique d'une question isolée. Il se joue ailleurs.
Test 2 : construire un simulateur de TJM freelance
Deuxième test, plus proche d'un vrai travail. J'ai demandé à chaque modèle de construire un simulateur qui calcule à partir de quel tarif journalier (le TJM) un freelance devient rentable. Une petite application, utilisable directement dans la conversation.
| Modèle | Ce qu'il a livré | Ce qui le distingue |
|---|---|---|
| Haiku | Un simulateur simple et fonctionnel : TJM, jours facturés, frais mensuels, un curseur, un calcul dynamique | Il fait le travail, sans plus |
| Sonnet | À peu près la même chose, avec un graphisme différent | Rien de décisif par rapport à Haiku |
| Opus | Le même socle, plus un réglage : congés répartis sur l'année, ou concentrés l'été et en fin d'année | Le seul à avoir pensé au mois d'août sans revenu |
| Fable | Un tableau de bord financier plus technique, plus précis sur certains calculs | Plus impressionnant, mais sans l'idée des congés |
Le détail qui fait la différence, c'est le réglage d'Opus. Un freelance qui part trois semaines en août n'encaisse rien ce mois-là. Sans ce paramètre, le graphique affiche un mois d'août dans le rouge et le TJM calculé est trop bas. Opus l'a anticipé sans qu'on le lui demande : le TJM se corrige et le graphique lisse les revenus sur l'année. C'est une idée métier, pas une prouesse technique.
Fable, lui, a produit l'interface la plus fournie, avec un rendu de tableau de bord de finance. Plus précis sur quelques points, mais il est passé à côté de la question des congés. Pour cette tâche, il n'apporte rien qui justifie de payer dix fois le prix de Haiku et deux fois et demie celui d'Opus.
Mon verdict après les deux tests
Sur des demandes isolées, les quatre modèles s'en sortent. La différence apparaît dans le jugement, pas dans la capacité brute.
- Opus : le meilleur rapport entre qualité et coût, et le plus d'initiative utile
- Sonnet : largement suffisant pour l'usage courant, en gratuit
- Haiku : fiable sur une question bien posée
- Fable : surdimensionné pour une demande ordinaire
- Haiku : à éviter dès que la tâche s'étire
Par défaut : Sonnet en gratuit, Opus en payant Tests réalisés dans l'application Claude, octobre 2026
À quoi servent vraiment les gros modèles
Si Haiku ou Sonnet font l'affaire sur ces deux tests, pourquoi payer pour Opus ou Fable ? Parce que mes tests sont des demandes uniques. Le vrai terrain des gros modèles, c'est l'enchaînement : une tâche qui demande d'utiliser plusieurs outils l'un après l'autre, sans perdre le fil.
Un exemple tiré de mon quotidien en SEO. Je demande à Claude de rédiger un article à ma manière, en s'appuyant sur des données récupérées par les connecteurs branchés sur mon compte, puis de ranger proprement le résultat dans un Google Sheet de suivi. Ça représente une dizaine d'étapes : lire mes consignes, appeler les bons connecteurs, appliquer une skill de rédaction, vérifier, écrire dans le tableur au bon endroit.
Sur ce genre de chaîne, la différence entre les modèles devient nette :
- Haiku et Sonnet peinent davantage. Ils posent plus de questions, s'arrêtent en route, et peuvent aller jusqu'à écraser une colonne ou abîmer un fichier en voulant bien faire.
- Opus et Fable tiennent la chaîne de bout en bout, choisissent les bons outils dans le bon ordre et vérifient ce qu'ils ont écrit.
C'est exactement ce que font Claude Cowork et Claude Code : déléguer une tâche entière plutôt que poser une question. Plus la tâche est longue et plus elle touche à de vrais fichiers, plus le modèle compte.
La règle que j'applique
Dès que Claude a le droit d'écrire quelque part (un tableur, un site, un dossier), je passe sur Opus. Une erreur de Sonnet dans une réponse de chat se corrige en relisant. Une erreur dans un fichier partagé se découvre trop tard.
Quand sortir Fable
Fable a sa place, mais elle est étroite. Je le sors dans deux cas :
- Le développement d'une application. Quand je construis un outil en vibe coding, c'est-à-dire en décrivant ce que je veux et en laissant Claude écrire le code, Fable va nettement plus loin que Sonnet : plus de fichiers cohérents entre eux, moins d'allers-retours pour corriger.
- La tâche qu'Opus ne termine pas. Un raisonnement très long, un gros volume de documents à croiser, un problème où Opus tourne en rond. Là, Fable vaut son prix.
En dehors de ces cas, Fable consomme votre quota pour un résultat que vous n'auriez pas distingué de celui d'Opus. Sur Pro, chaque usage de Fable passe en plus par des crédits payants.
Et Mythos, alors ?
Vous avez peut-être lu le nom de Claude Mythos, présenté comme le modèle le plus puissant d'Anthropic. Vous ne le trouverez pas dans le sélecteur, même avec l'abonnement Max à 200 $ par mois. Je l'ai vérifié sur mon propre compte.
La raison est simple : Mythos 5.1 est le même modèle que Fable 5.1. La différence porte sur les garde-fous. Fable est livré avec des protections supplémentaires, notamment en cybersécurité. Mythos les a levées, et son accès est réservé à des organisations vérifiées qui en ont besoin pour leur travail, en cybersécurité et en sciences de la vie. Ce n'est donc pas un modèle « au-dessus » de Fable que le grand public attendrait : c'est Fable, débridé, pour des usages encadrés. L'histoire de ce lancement est dans l'origine de Claude AI.
L'effort : le réglage que personne ne regarde
Sous le choix du modèle se cache un second réglage, souvent ignoré : le niveau d'effort. Dans le sélecteur, chaque modèle en propose cinq : faible, moyen, élevé, extra et max. Dans Claude Code, un cran supplémentaire apparaît encore au-dessus.
Contrairement à ce que son nom laisse croire, l'effort ne rend pas le modèle plus intelligent. Il lui donne plus de temps : plus de réflexion avant de répondre, plus de recherches, plus de vérifications. Comme quelqu'un qui se concentre davantage, avec les mêmes capacités.
| Effort | Ce que ça change | Quand je l'utilise |
|---|---|---|
| Faible | Réponse rapide, réflexion minimale | Reformuler, traduire, répondre à une question simple |
| Moyen | Le bon équilibre pour l'usage courant | Rédiger, résumer, analyser un document court |
| Élevé | Réflexion plus poussée, plus de vérifications | Une analyse qui compte, une tâche en plusieurs étapes |
| Extra | Nettement plus long et plus coûteux | Un problème difficile sur lequel l'élevé a échoué |
| Max | Le modèle prend tout le temps qu'il juge utile | Un gros chantier, lancé en sachant ce qu'il va coûter |
L'écart de durée est réel. Sur une tâche lourde, une réponse en effort faible peut tomber en deux minutes quand la même demande en effort max prendra trente minutes, voire une heure. La réponse sera généralement plus juste et plus fouillée, mais elle consommera aussi beaucoup plus de votre limite.
Attention sur l'abonnement à 20 $
Sur Pro, quelques demandes en effort max suffisent à vider votre session de cinq heures. Gardez l'effort moyen par défaut et montez seulement quand la réponse ne suffit pas. Le bon réflexe : changer d'effort avant de changer de modèle.
Ma règle tient en une phrase : le modèle se choisit selon la nature de la tâche, l'effort selon son enjeu. Une tâche simple mais importante, c'est Sonnet en effort élevé. Une tâche complexe mais exploratoire, c'est Opus en effort moyen. L'outil ci-dessous fait ce raisonnement à votre place.
Mes réglages au quotidien
Pour finir, voici ce que j'utilise réellement, sur un abonnement Max, au fil d'une journée de travail :
- Opus par défaut, en effort moyen, pour presque tout : rédaction, analyse SEO, préparation d'un rendez-vous client.
- Opus en effort plus élevé dès que Claude enchaîne des outils et écrit quelque part : un tableur client, un site, un dossier partagé.
- Fable pour les sessions de vibe coding, quand je construis une application de plusieurs fichiers.
- Haiku pour une question rapide dans le chat, quand je veux une réponse immédiate et rien de plus.
Si vous êtes en version gratuite, la même logique s'applique avec Sonnet à la place d'Opus : effort moyen par défaut, élevé quand l'enjeu le justifie. Et si vous hésitez encore entre Claude et la concurrence, j'ai comparé les deux outils usage par usage dans Claude vs ChatGPT. La prochaine vidéo passera d'ailleurs les modèles de ChatGPT au même crible.
Questions fréquentes
Quel modèle Claude choisir ?
En version gratuite, Sonnet : il couvre la rédaction, la synthèse, l'analyse de documents et le code simple. En version payante, Opus par défaut : il fait presque tout ce que fait Fable pour une fraction du coût, et il tient mieux les tâches en plusieurs étapes. Haiku sert aux questions rapides, Fable aux gros projets de code et aux tâches qu'Opus ne termine pas.
Quelle est la différence entre Haiku, Sonnet, Opus et Fable ?
Les quatre modèles partagent la même interface et les mêmes outils. Ils diffèrent par la vitesse, la profondeur de raisonnement et le prix : Haiku 4.5 est le plus rapide, Sonnet 5.5 couvre l'usage courant, Opus 5.5 gère le travail complexe et Fable 5.1 est le plus capable. À l'API, Sonnet coûte deux fois Haiku, Opus quatre fois, Fable dix fois.
Quels modèles Claude sont disponibles en version gratuite ?
Le plan gratuit donne accès à Sonnet et Haiku. Opus est disponible à partir de l'abonnement Pro, à 20 $ par mois ou 17 $ par mois en annuel. Fable est inclus dans Max, jusqu'à la moitié de la limite hebdomadaire, et s'utilise sur Pro avec des crédits d'usage facturés en plus.
Fable vaut-il le coup par rapport à Opus ?
Rarement. Dans mes tests, Opus a eu la meilleure idée métier sur un simulateur de TJM freelance, alors que Fable a livré une interface plus technique sans cette idée. Fable se justifie pour le développement d'une application en vibe coding et pour les tâches très longues où Opus plafonne. Le reste du temps, il consomme votre quota sans résultat visiblement meilleur.
Qu'est-ce que Claude Mythos et pourquoi n'est-il pas accessible ?
Mythos 5.1 est le même modèle que Fable 5.1, sans une partie des garde-fous, notamment en cybersécurité. Son accès est réservé à des organisations vérifiées qui en ont besoin, en cybersécurité et en sciences de la vie. Il n'apparaît dans le sélecteur d'aucune formule grand public, même Max à 200 $ par mois.
À quoi sert le niveau d'effort dans Claude ?
Le niveau d'effort (faible, moyen, élevé, extra, max) règle le temps de réflexion que le modèle s'accorde avant de répondre. Il ne rend pas le modèle plus intelligent, mais lui permet de chercher et de vérifier davantage. Une réponse peut passer de deux minutes en effort faible à trente minutes ou plus en effort max, avec une consommation de quota en proportion.
Quel modèle Claude consomme le moins de quota ?
Haiku, suivi de Sonnet. Chaque message consomme votre limite en proportion du modèle et du niveau d'effort : Fable en effort max est le réglage le plus coûteux. Pour faire durer un abonnement Pro, gardez Sonnet ou Opus en effort moyen par défaut, et changez d'effort avant de changer de modèle.
Mettre le bon modèle sur la bonne tâche, dans votre équipe
Choisir les outils, régler les modèles, construire les automatisations qui tiennent en production : je forme les équipes à l'usage réel de Claude et je conçois les chaînes qui leur font gagner du temps.
Écrit par
Anthony Courtin
Avis des lecteurs
Cet article vous a servi ? Dites-le, ça aide les suivants.
Ce qu'en disent les lecteurs
Soyez le premier à donner votre avis.


