
Abre el selector de modelos de Claude y te encuentras con cuatro nombres: Haiku, Sonnet, Opus y Fable. Anthropic los ordena del más ligero al más potente, lo que lleva a una conclusión lógica: elegir el más grande, ya que está ahí. Rara vez es la elección correcta, y a menudo es incluso un mal cálculo.
Para comprobarlo, les di exactamente las mismas instrucciones a los cuatro modelos, en la misma interfaz, y comparé lo que salía. Todo está en el vídeo (en francés), en seis minutos. Este artículo recoge los resultados, añade lo que no tuve tiempo de detallar en pantalla (los planes, los precios, el nivel de esfuerzo) y termina con una herramienta que te dice qué modelo y qué esfuerzo configurar para tu tarea.
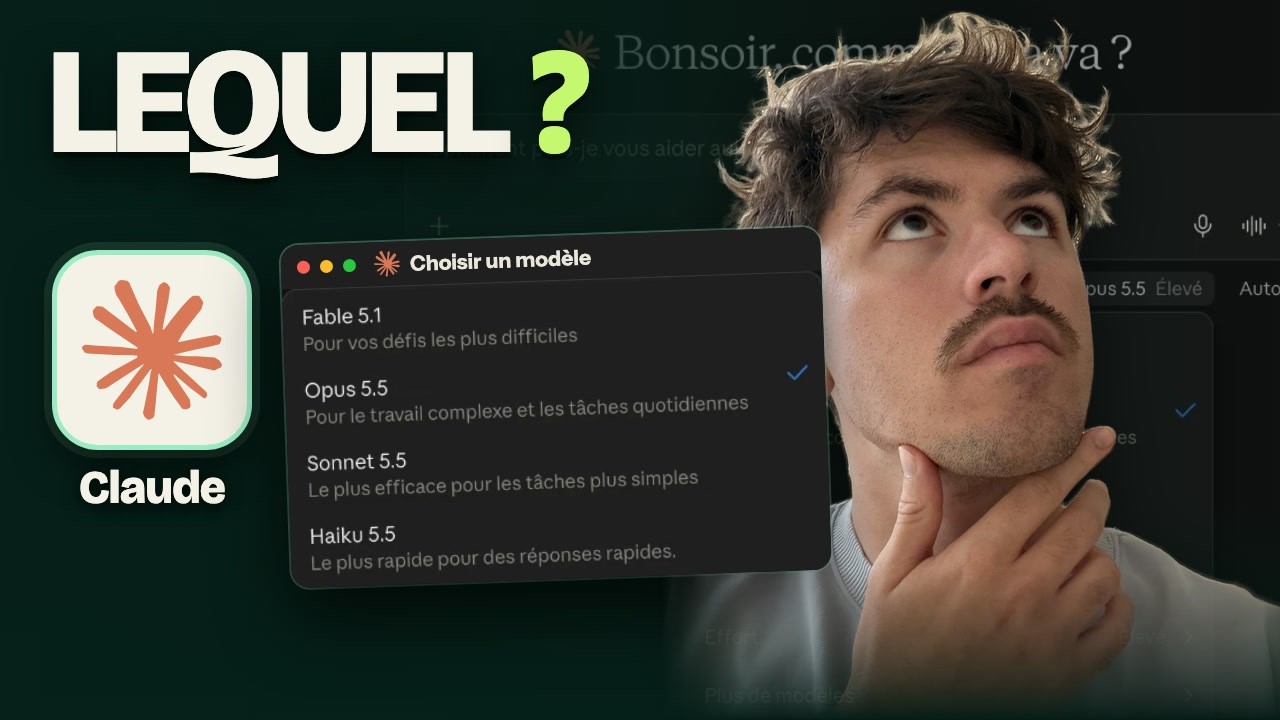 Haiku, Sonnet, Opus o Fable: la comparativa en 5 min 57 (en francés)
Los capítulos del vídeo (en francés): 0:00 la respuesta corta · 0:41 prueba 1, una agenda imposible · 1:23 prueba 2, construir una herramienta real · 2:56 para qué sirven los modelos grandes · 4:16 ¿y Mythos? · 4:45 el esfuerzo, el ajuste oculto · 5:49 en resumen.
Lo esencial
- Claude ofrece cuatro modelos en octubre de 2026: Haiku 4.5, Sonnet 5.5, Opus 5.5 y Fable 5.1, del más rápido al más capaz.
- En la versión gratuita, me quedo con Sonnet. En la versión de pago, configuro Opus por defecto: hace casi todo lo que hace Fable, por una fracción del coste.
- Ante una pregunta trampa (una agenda imposible), los cuatro modelos detectaron que no existía ninguna solución, Haiku incluido.
- En un simulador de tarifa diaria para freelance, fue Opus el que tuvo la mejor idea de negocio. Fable entregó el panel más técnico, sin esa idea.
- Los modelos grandes marcan la diferencia en las tareas de varios pasos (conectores, skills, archivos) y en el código largo, no en una pregunta aislada.
- El nivel de esfuerzo no hace al modelo más inteligente: le da más tiempo para pensar, y consume tu cuota en la misma proporción.
Qué modelo de Claude elegir: la respuesta corta
Si solo tuvieras que leer un párrafo: en gratis, Sonnet; de pago, Opus. Haiku para las tareas pequeñas en serie, Fable para los grandes proyectos de código o las tareas largas que Opus no termina.
| Modelo | Para qué | Plan | Mi uso |
|---|---|---|---|
| Haiku 4.5 | El más rápido: preguntas cortas, reformulaciones, clasificación, tareas repetitivas | Todos, gratuito incluido | Las preguntas sencillas, cuando la velocidad importa |
| Sonnet 5.5 | El uso habitual: redacción, síntesis, documentos, hojas de cálculo, código sencillo | Todos, gratuito incluido | Mi elección por defecto en la versión gratuita |
| Opus 5.5 | El trabajo complejo: razonamiento largo, análisis, tareas de varios pasos | Pro y superiores | Mi elección por defecto en la versión de pago |
| Fable 5.1 | El más capaz: código ambicioso, tareas muy largas y exigentes | Max y asientos Premium; Pro con créditos de uso | Solo cuando Opus llega a su techo |
¿Por qué no Fable siempre, si es el más potente? Porque a menudo es demasiado pesado para la tarea pedida. Piensa durante más tiempo, cuesta bastante más y, ante una petición corriente, no da un resultado mejor que Opus. Anthropic lo dice a su manera: según sus propias mediciones, Opus 5.5 alcanza el nivel de Fable 5.1 en la mayoría de las tareas. Las dos pruebas que siguen lo demuestran en concreto.
Gama y precios consultados el 14 de octubre de 2026
En la aplicación de Claude y en la página de precios de Anthropic. Los nombres de versión cambian varias veces al año; la lógica de la elección, mucho menos. Para el detalle de los planes, consulta la suscripción a Claude, precios y planes.
Los cuatro modelos de Claude de un vistazo
Los cuatro modelos comparten la misma interfaz, las mismas herramientas y los mismos conectores. Lo que cambia: la velocidad, la profundidad de razonamiento y el precio de cada palabra producida. En la API, la diferencia se ve directamente:
| Modelo | Entrada, por millón de tokens | Salida, por millón de tokens | Diferencia con Haiku |
|---|---|---|---|
| Haiku 4.5 | 1 $ | 5 $ | Referencia |
| Sonnet 5.5 | 2 $ | 10 $ | × 2 |
| Opus 5.5 | 4 $ | 20 $ | × 4 |
| Fable 5.1 | 10 $ | 50 $ | × 10 |
En la suscripción no ves estos precios, pero los pagas igualmente: cada mensaje consume tu límite de sesión en proporción al modelo y al esfuerzo elegidos. Un intercambio con Fable en esfuerzo máximo pesa mucho más que un intercambio con Sonnet en esfuerzo medio. Por eso la elección del modelo no es solo una cuestión de calidad: también es una cuestión de autonomía a lo largo del día.
El plan gratuito da acceso a Sonnet y Haiku. Opus llega con Pro, a 20 $ al mes (17 $ con pago anual). Fable está incluido en Max (100 $ o 200 $ al mes), hasta la mitad del límite semanal, y se usa en Pro con créditos de uso que se facturan aparte. Detallo lo que permite el plan gratuito en Claude AI gratis.
Prueba 1: una agenda imposible
Primera prueba, con trampa a propósito. Les pedí a todos los modelos que encajaran una serie de citas en una semana, con restricciones de disponibilidad y de encadenamiento que, sumadas, se excluyen entre sí. No existe ninguna agenda válida. La respuesta correcta, por tanto, no es una agenda: es «no es posible, y este es el motivo».
Es el tipo de pregunta en la que un modelo débil tiende a inventar: quiere ayudar, así que produce una agenda que parece limpia y que incumple discretamente una restricción. La mejor defensa sigue siendo darle al modelo todos los datos en el mensaje: en este punto, el contexto importa más que la formulación del prompt.
Resultado: los cuatro lo detectaron. Haiku, el más pequeño, identificó el conflicto, explicó que ninguna solución respetaba todas las restricciones y luego me hizo preguntas para saber cuál flexibilizar. Sonnet, Opus y Fable llegaron a la misma conclusión, con explicaciones más o menos detalladas.
Lo que dice realmente esta prueba
Ante una pregunta bien planteada, con todos los datos en el mensaje, incluso el modelo más pequeño de Claude razona bien. La diferencia entre los modelos no está en la lógica de una pregunta aislada. Está en otra parte.
Prueba 2: construir un simulador de tarifa diaria para freelance
Segunda prueba, más cercana a un trabajo real. Les pedí a todos los modelos que construyeran un simulador que calcula a partir de qué tarifa diaria (lo que en Francia se llama TJM) un freelance empieza a ser rentable. Una pequeña aplicación, utilizable directamente en la conversación.
| Modelo | Lo que entregó | Lo que lo distingue |
|---|---|---|
| Haiku | Un simulador sencillo y funcional: tarifa diaria, días facturados, gastos mensuales, un control deslizante, un cálculo dinámico | Hace el trabajo, sin más |
| Sonnet | Más o menos lo mismo, con un diseño gráfico diferente | Nada decisivo frente a Haiku |
| Opus | La misma base, más un ajuste: vacaciones repartidas a lo largo del año, o concentradas en verano y a final de año | El único que pensó en el mes de agosto sin ingresos |
| Fable | Un panel financiero más técnico, más preciso en algunos cálculos | Más impresionante, pero sin la idea de las vacaciones |
El detalle que marca la diferencia es el ajuste de Opus. Un freelance que se va tres semanas en agosto no ingresa nada ese mes. Sin ese parámetro, el gráfico muestra un mes de agosto en rojo y la tarifa diaria calculada es demasiado baja. Opus lo anticipó sin que nadie se lo pidiera: la tarifa diaria se corrige y el gráfico suaviza los ingresos a lo largo del año. Es una idea de negocio, no una proeza técnica.
Fable, por su parte, produjo la interfaz más completa, con aspecto de panel financiero. Más preciso en algunos puntos, pero se le escapó la cuestión de las vacaciones. Para esta tarea, no aporta nada que justifique pagar diez veces el precio de Haiku y dos veces y media el de Opus.
Mi veredicto tras las dos pruebas
Ante peticiones aisladas, los cuatro modelos cumplen. La diferencia aparece en el criterio, no en la capacidad bruta.
- Opus: la mejor relación entre calidad y coste, y la mayor iniciativa útil
- Sonnet: más que suficiente para el uso habitual, en gratis
- Haiku: fiable ante una pregunta bien planteada
- Fable: sobredimensionado para una petición corriente
- Haiku: mejor evitarlo en cuanto la tarea se alarga
Por defecto: Sonnet en gratis, Opus de pago Pruebas realizadas en la aplicación de Claude, octubre de 2026
Para qué sirven de verdad los modelos grandes
Si Haiku o Sonnet cumplen en estas dos pruebas, ¿por qué pagar por Opus o Fable? Porque mis pruebas son peticiones únicas. El verdadero terreno de los modelos grandes es el encadenamiento: una tarea que exige usar varias herramientas una tras otra, sin perder el hilo.
Un ejemplo de mi día a día en SEO. Le pido a Claude que redacte un artículo a mi manera, apoyándose en datos obtenidos por los conectores enlazados a mi cuenta, y que después guarde el resultado de forma ordenada en un Google Sheet de seguimiento. Eso supone una decena de pasos: leer mis instrucciones, llamar a los conectores adecuados, aplicar un skill de redacción, verificar, escribir en la hoja de cálculo en el lugar correcto.
En este tipo de cadena, la diferencia entre los modelos se vuelve clara:
- Haiku y Sonnet tienen más dificultades. Hacen más preguntas, se detienen por el camino y pueden llegar a sobrescribir una columna o estropear un archivo por querer hacerlo bien.
- Opus y Fable mantienen la cadena de principio a fin, eligen las herramientas adecuadas en el orden correcto y verifican lo que han escrito.
Es exactamente lo que hacen Claude Cowork y Claude Code: delegar una tarea entera en lugar de hacer una pregunta. Cuanto más larga es la tarea y más toca archivos reales, más importa el modelo.
La regla que aplico
En cuanto Claude tiene permiso para escribir en algún sitio (una hoja de cálculo, una web, una carpeta), paso a Opus. Un error de Sonnet en una respuesta del chat se corrige al releer. Un error en un archivo compartido se descubre demasiado tarde.
Cuándo sacar Fable
Fable tiene su lugar, pero es estrecho. Lo saco en dos casos:
- El desarrollo de una aplicación. Cuando construyo una herramienta en vibe coding, es decir, describiendo lo que quiero y dejando que Claude escriba el código, Fable llega bastante más lejos que Sonnet: más archivos coherentes entre sí, menos idas y venidas para corregir.
- La tarea que Opus no termina. Un razonamiento muy largo, un gran volumen de documentos que cruzar, un problema en el que Opus da vueltas en círculo. Ahí, Fable vale lo que cuesta.
Fuera de estos casos, Fable consume tu cuota para un resultado que no habrías distinguido del de Opus. En Pro, además, cada uso de Fable pasa por créditos de pago.
¿Y Claude Mythos?
Quizá hayas leído el nombre de Claude Mythos, presentado como el modelo más potente de Anthropic. No lo encontrarás en el selector, ni siquiera con la suscripción Max de 200 $ al mes. Lo he comprobado en mi propia cuenta.
La razón es sencilla: Mythos 5.1 es el mismo modelo que Fable 5.1. La diferencia está en las salvaguardas. Fable se entrega con protecciones adicionales, sobre todo en ciberseguridad. Mythos las ha levantado, y su acceso está reservado a organizaciones verificadas que lo necesitan para su trabajo, en ciberseguridad y en ciencias de la vida. No es, por tanto, un modelo «por encima» de Fable que el gran público esté esperando: es Fable, sin frenos, para usos controlados. La historia de este lanzamiento está en el origen de Claude AI.
El esfuerzo: el ajuste que nadie mira
Debajo de la elección del modelo se esconde un segundo ajuste, a menudo ignorado: el nivel de esfuerzo. En el selector, cada modelo ofrece cinco: bajo, medio, alto, extra y máximo. En Claude Code aparece incluso un nivel más por encima.
Al contrario de lo que sugiere su nombre, el esfuerzo no hace al modelo más inteligente. Le da más tiempo: más reflexión antes de responder, más búsquedas, más verificaciones. Como alguien que se concentra más, con las mismas capacidades.
| Esfuerzo | Qué cambia | Cuándo lo uso |
|---|---|---|
| Bajo | Respuesta rápida, reflexión mínima | Reformular, traducir, responder a una pregunta sencilla |
| Medio | El equilibrio adecuado para el uso habitual | Redactar, resumir, analizar un documento corto |
| Alto | Reflexión más profunda, más verificaciones | Un análisis que importa, una tarea de varios pasos |
| Extra | Bastante más largo y más costoso | Un problema difícil en el que el nivel alto ha fallado |
| Máximo | El modelo se toma todo el tiempo que considera útil | Un gran proyecto, lanzado sabiendo lo que va a costar |
La diferencia de duración es real. En una tarea pesada, una respuesta en esfuerzo bajo puede llegar en dos minutos, mientras que la misma petición en esfuerzo máximo tardará treinta minutos, o incluso una hora. La respuesta será, en general, más acertada y más completa, pero también consumirá mucho más de tu límite.
Cuidado con la suscripción de 20 $
En Pro, unas pocas peticiones en esfuerzo máximo bastan para agotar tu sesión de cinco horas. Mantén el esfuerzo medio por defecto y súbelo solo cuando la respuesta no sea suficiente. El buen reflejo: cambiar de esfuerzo antes de cambiar de modelo.
Mi regla cabe en una frase: el modelo se elige según la naturaleza de la tarea; el esfuerzo, según lo que está en juego. Una tarea sencilla pero importante: Sonnet en esfuerzo alto. Una tarea compleja pero exploratoria: Opus en esfuerzo medio. La herramienta de abajo hace este razonamiento por ti.
Mi configuración en el día a día
Para terminar, esto es lo que uso realmente, con una suscripción Max, a lo largo de una jornada de trabajo:
- Opus por defecto, en esfuerzo medio, para casi todo: redacción, análisis SEO, preparación de una reunión con un cliente.
- Opus con un esfuerzo más alto en cuanto Claude encadena herramientas y escribe en algún sitio: una hoja de cálculo de un cliente, una web, una carpeta compartida.
- Fable para las sesiones de vibe coding, cuando construyo una aplicación de varios archivos.
- Haiku para una pregunta rápida en el chat, cuando quiero una respuesta inmediata y nada más.
Si estás en la versión gratuita, se aplica la misma lógica con Sonnet en lugar de Opus: esfuerzo medio por defecto, alto cuando lo que está en juego lo justifica. Y si todavía dudas entre Claude y la competencia, he comparado las dos herramientas uso por uso en Claude vs ChatGPT. Mi próximo vídeo (en francés) someterá además los modelos de ChatGPT a la misma criba.
Preguntas frecuentes
¿Qué modelo de Claude elegir?
En la versión gratuita, Sonnet: cubre la redacción, la síntesis, el análisis de documentos y el código sencillo. En la versión de pago, Opus por defecto: hace casi todo lo que hace Fable por una fracción del coste, y aguanta mejor las tareas de varios pasos. Haiku sirve para las preguntas rápidas; Fable, para los grandes proyectos de código y las tareas que Opus no termina.
¿Qué diferencia hay entre Haiku, Sonnet, Opus y Fable?
Los cuatro modelos comparten la misma interfaz y las mismas herramientas. Se diferencian en la velocidad, la profundidad de razonamiento y el precio: Haiku 4.5 es el más rápido, Sonnet 5.5 cubre el uso habitual, Opus 5.5 se encarga del trabajo complejo y Fable 5.1 es el más capaz. En la API, Sonnet cuesta el doble que Haiku, Opus cuatro veces más y Fable diez veces más.
¿Qué modelos de Claude están disponibles en la versión gratuita?
El plan gratuito da acceso a Sonnet y Haiku. Opus está disponible a partir de la suscripción Pro, a 20 $ al mes o 17 $ al mes con pago anual. Fable está incluido en Max, hasta la mitad del límite semanal, y se usa en Pro con créditos de uso que se facturan aparte.
¿Merece la pena Fable frente a Opus?
Rara vez. En mis pruebas, Opus tuvo la mejor idea de negocio en un simulador de tarifa diaria para freelance, mientras que Fable entregó una interfaz más técnica sin esa idea. Fable se justifica para desarrollar una aplicación en vibe coding y para las tareas muy largas en las que Opus llega a su techo. El resto del tiempo, consume tu cuota sin un resultado visiblemente mejor.
¿Qué es Claude Mythos y por qué no está disponible?
Mythos 5.1 es el mismo modelo que Fable 5.1, sin parte de las salvaguardas, sobre todo en ciberseguridad. Su acceso está reservado a organizaciones verificadas que lo necesitan, en ciberseguridad y en ciencias de la vida. No aparece en el selector de ningún plan para el gran público, ni siquiera en Max de 200 $ al mes.
¿Para qué sirve el nivel de esfuerzo en Claude?
El nivel de esfuerzo (bajo, medio, alto, extra, máximo) regula el tiempo de reflexión que se toma el modelo antes de responder. No hace al modelo más inteligente, pero le permite buscar y verificar más. Una respuesta puede pasar de dos minutos en esfuerzo bajo a treinta minutos o más en esfuerzo máximo, con un consumo de cuota proporcional.
¿Qué modelo de Claude consume menos cuota?
Haiku, seguido de Sonnet. Cada mensaje consume tu límite en proporción al modelo y al nivel de esfuerzo: Fable en esfuerzo máximo es la configuración más costosa. Para que una suscripción Pro te dure, mantén Sonnet u Opus en esfuerzo medio por defecto, y cambia de esfuerzo antes de cambiar de modelo.
Poner el modelo adecuado en la tarea adecuada, en tu equipo
Elegir las herramientas, configurar los modelos, construir automatizaciones que aguantan en producción: formo a los equipos en el uso real de Claude y diseño las cadenas que les hacen ganar tiempo.
Escrito por
Anthony Courtin
Opiniones de los lectores
¿Te ha servido este artículo? Dilo, ayuda a los siguientes lectores.
Lo que dicen los lectores
Sé el primero en dar tu opinión.


